Prácticas de ingeniería
Buenas prácticas para nombrar ramas y commits semánticos
Cómo hacer que el historial del repositorio documente el propio proyecto.
 Cristiano Rego Barros
4 min de lectura
Publicado originalmente en Medium
En el día a día de la computación y la ingeniería de software, Git y el control de versiones se han vuelto herramientas indispensables. Surgieron para controlar versiones de archivos y se adoptaron para gestionar el código fuente de aplicaciones, trayendo consigo diversos conceptos como commit, branch, gitflow, etc.
Tareas como las del siguiente paso a paso forman parte del flujo de trabajo de la mayoría de los desarrolladores del mundo:
- Crear tu rama de trabajo;
- Empezar tus tareas;
- Hacer commits frecuentes;
- Terminar tu tarea;
- Crear una solicitud de fusión (PR o MR) hacia una rama principal.
Sin embargo, solo seguir estos pasos no significa que tu control de versiones esté sano. Un buen versionado va mucho más allá del flujo de trabajo con ramas y commits. Un código bien versionado es fácil de entender para nuevos desarrolladores y para cualquier profesional que lo visite: deja claro qué actividades se realizaron y cuáles fueron los flujos de trabajo hasta el momento.
Nombres de ramas
En escenarios como el de la imagen de abajo, se nota lo confuso que se vuelve entender qué se hizo en cada rama, lo que dificulta su mantenimiento.
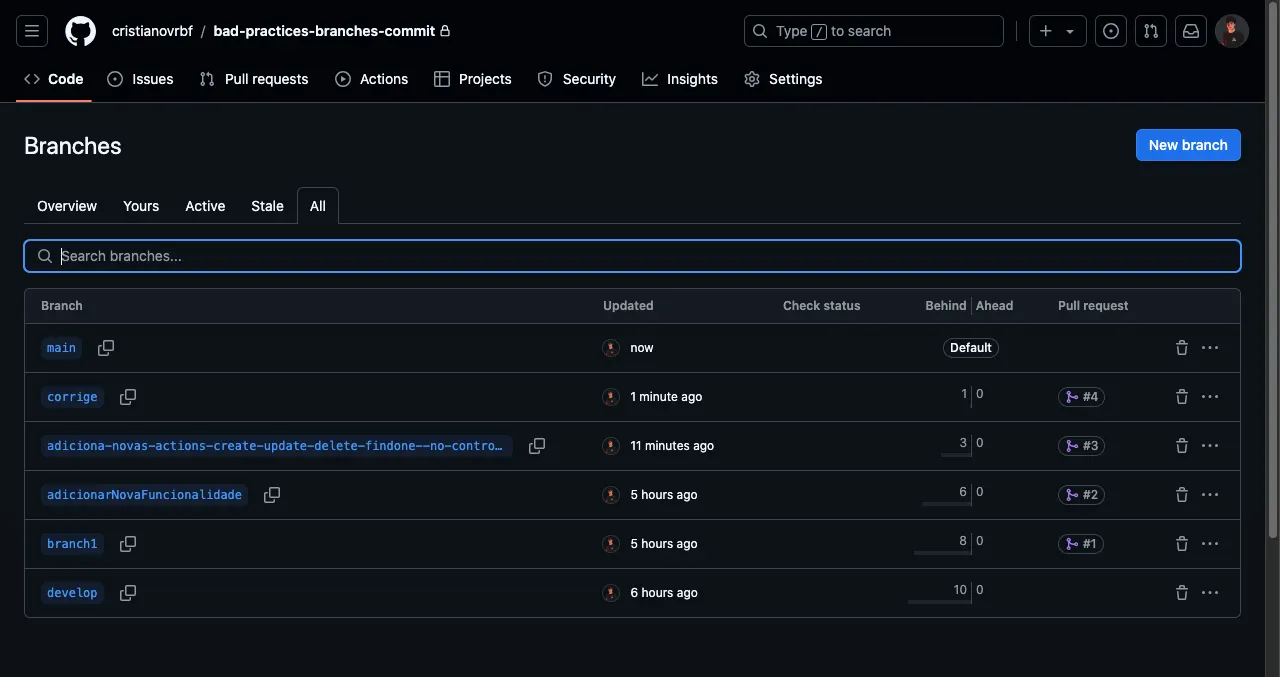
En estos escenarios, las ramas pueden presentar los siguientes problemas:
- Nombres vagos: la falta de una descripción clara dificulta entender el propósito de la rama y reduce la productividad, ya que hay que abrir cada una para ver qué se hizo.
- Falta de claridad en el objetivo: no queda claro si la rama se creó para implementar una funcionalidad, corregir un bug, hacer mejoras, ajustar configuraciones o modificar la documentación.
- Dificultad de seguimiento: encontrar cambios específicos se complica, sobre todo en listas largas de ramas con nombres genéricos o inconsistentes.
- Nombres largos y confusos: las ramas con nombres demasiado largos son difíciles de recordar y manejar, y aumentan el riesgo de errores al referenciarlas.
- Complejidad en la comunicación: la falta de un estándar vuelve más confuso y propenso a errores el intercambio de información entre desarrolladores.
- Poca transparencia en los objetivos del código: no queda claro qué problemas o demandas intenta resolver la rama, lo que perjudica las revisiones de código y la colaboración.
Surgen entonces los estándares de nombres de ramas, para que el proyecto se convierta en su propia documentación, transformando el mantenimiento y la auditoría de cambios y mejoras a lo largo de la línea de tiempo del proyecto.
El estándar parte de un prefijo que indica el motivo de la rama, seguido de una descripción corta:
| Prefijo | Motivo |
|---|---|
| feature/ | Implementación de nuevas funcionalidades |
| bugfix/ | Corrección de bugs |
| hotfix/ | Correcciones de emergencia |
| release/ | Publicación de nuevas versiones |
| refactor/ | Refactorización del código sin cambios funcionales |
| test/ | Implementación y cambios en las pruebas |
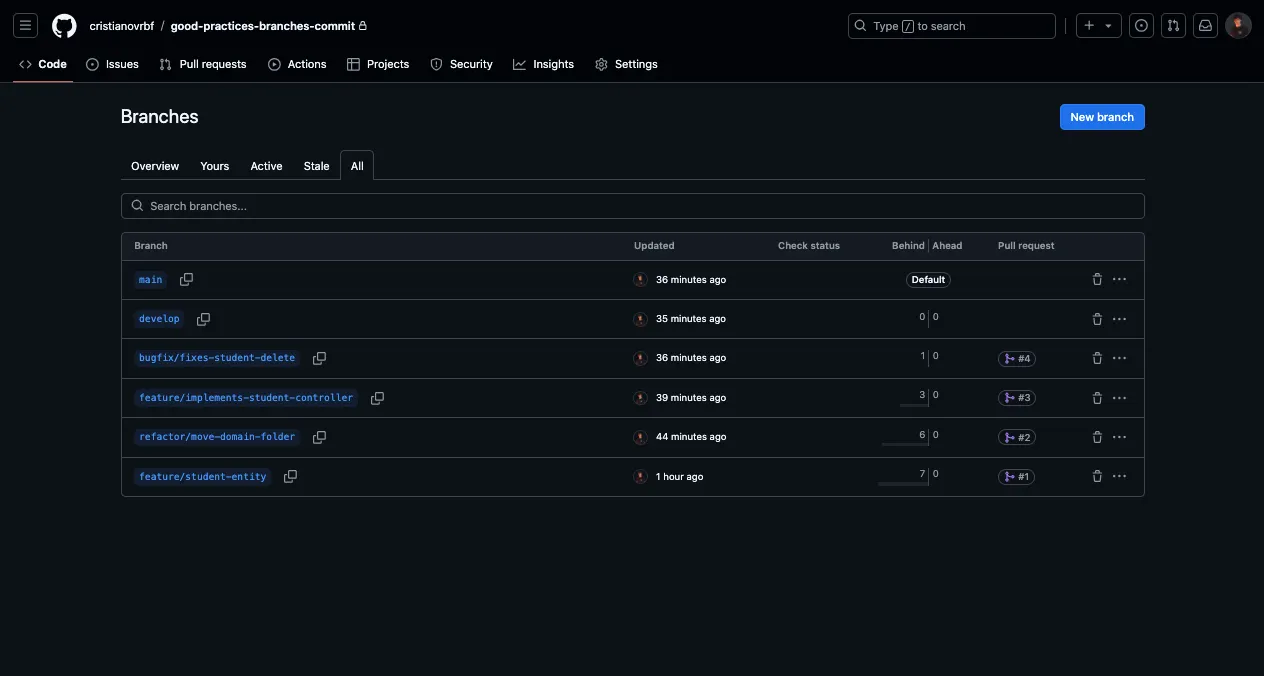
En la imagen de abajo se nota la importancia de la estandarización: es fácil entender por qué se creó cada rama y qué se desarrolló en ella, además de facilitar la memorización y la comunicación entre desarrolladores.
Escritura de commits
Los mensajes de commit deben ser fáciles y rápidos de entender, y transmitir con claridad qué cambios se hicieron.
Los mensajes sin estándar dificultan las revisiones de código, perjudican la claridad de la línea de tiempo del proyecto y complican la búsqueda de cambios específicos. Al igual que la falta de estándar en los nombres de ramas, la ausencia de reglas al escribir commits desvaloriza el control de versiones.
Surge entonces la estandarización de los mensajes de commit según el tipo de cambio realizado, como en la tabla de abajo:
| Prefijo | Tipo de cambio |
|---|---|
| feat | Agrega una nueva funcionalidad |
| fix | Corrige un bug |
| docs | Cambios en la documentación |
| style | Cambios que no afectan la lógica (espaciado, formato, etc.) |
| refactor | Cambios en el código que no alteran el comportamiento |
| perf | Mejoras de rendimiento |
| test | Agregar o ajustar pruebas |
| chore | Tareas de mantenimiento, como actualizar dependencias |
Así, cada commit puede seguir este patrón:
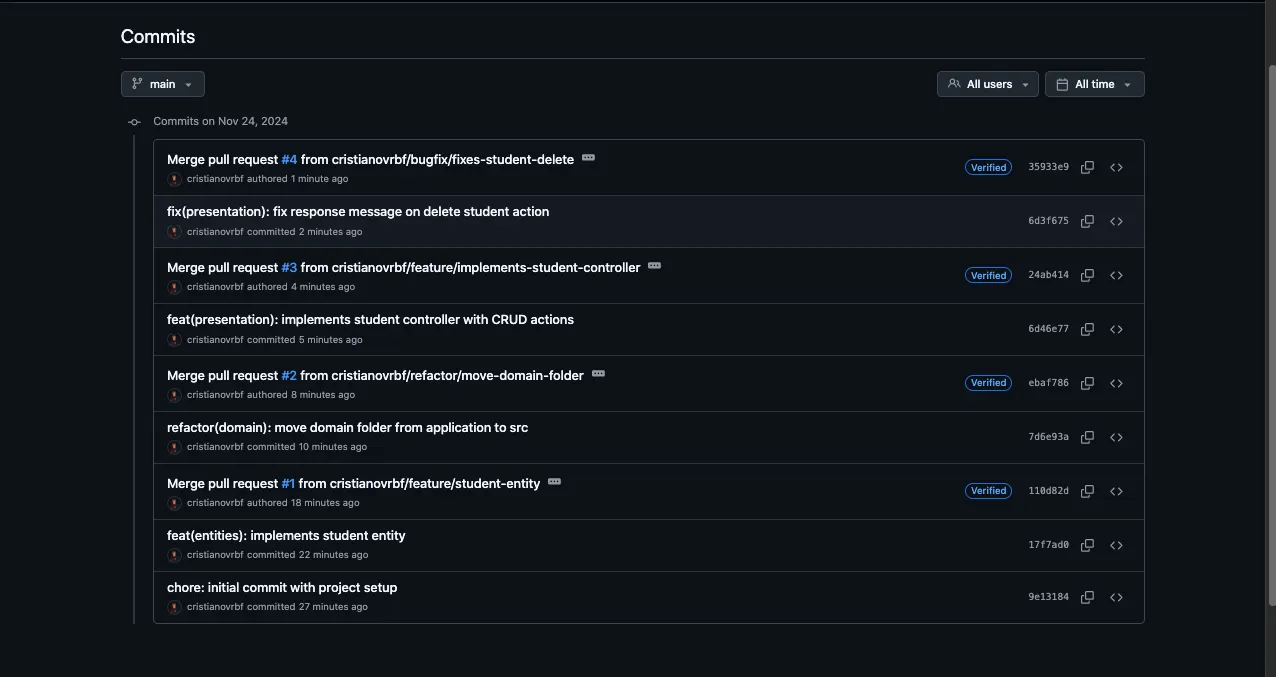
prefijo(módulo-modificado): descripción breve del cambioEn la imagen de abajo se nota la claridad que la estandarización aporta al proyecto: de forma rápida y sencilla se entiende qué se hizo en cada commit.
Conclusión
Queda claro el valor de implementar estas prácticas en tu proyecto: mejoran el control de versiones y la estructura de la línea de tiempo, hacen que el propio proyecto se convierta en su documentación y facilitan el día a día de los desarrolladores.