Práticas de engenharia
Boas práticas em nomenclaturas de branch e commits semânticos
Como fazer o histórico do repositório documentar o próprio projeto.
 Cristiano Rego Barros
4 min de leitura
Publicado originalmente no Medium
No dia a dia da computação e da engenharia de software, o Git e o versionamento de código já se tornaram ferramentas indispensáveis. Esses instrumentos surgiram para controlar versões de arquivos e foram adotados para gerenciar o código-fonte de aplicações, trazendo consigo diversos conceitos como commit, branch, gitflow etc.
Tarefas como as do passo a passo abaixo fazem parte do fluxo de trabalho da maioria dos desenvolvedores ao redor do mundo:
- Criar sua branch de trabalho;
- Iniciar suas demandas;
- Realizar commits frequentes;
- Finalizar sua demanda;
- Criar uma requisição de mesclagem (PR ou MR) com uma branch principal.
Entretanto, apenas seguir esses passos não significa que seu versionamento de código está saudável. Um bom versionamento vai muito além do fluxo de trabalho com branches e commits. Uma base de código bem versionada é fácil de entender para novos desenvolvedores e para qualquer profissional que a visite: deixa claro quais atividades foram realizadas e quais foram os fluxos de trabalho até o momento atual.
Nomenclatura de branches
Em cenários como o da imagem abaixo, nota-se o quão confuso se torna entender o que foi realizado em cada branch, o que dificulta sua manutenção.
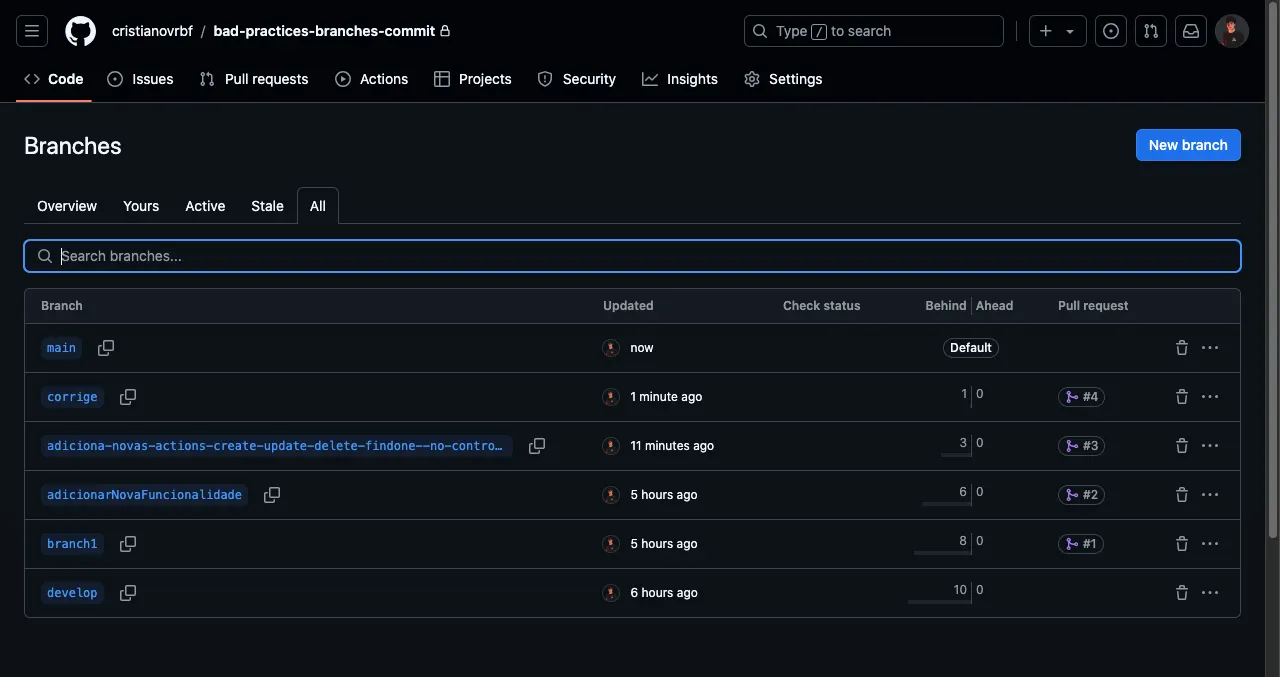
Nesses cenários, as branches podem apresentar os seguintes problemas:
- Nomes vagos: a ausência de descrição clara dificulta a compreensão do propósito da branch, levando à perda de produtividade, já que é preciso abrir cada uma para entender o que foi feito.
- Falta de clareza no objetivo: não fica evidente se a branch foi criada para implementar uma funcionalidade, corrigir um bug, fazer melhorias, ajustar configurações ou modificar a documentação.
- Dificuldade de rastreamento: localizar mudanças específicas fica complicado, especialmente em listas longas de branches com nomes genéricos ou inconsistentes.
- Nomes extensos e confusos: branches com nomes longos demais são difíceis de lembrar e manusear, aumentando o risco de erros ao referenciá-las.
- Complexidade na comunicação: a falta de padrão torna o compartilhamento de informações entre desenvolvedores mais confuso e propenso a falhas.
- Pouca transparência nos objetivos do código: não fica claro quais problemas ou demandas a branch tenta resolver, prejudicando revisões de código e a colaboração.
Surgem, então, os padrões de nomenclatura de branches, para que o projeto se torne sua própria documentação — transformando a manutenção e a auditoria de mudanças e melhorias ao longo da linha do tempo do projeto.
O padrão parte de um prefixo que indica o motivo da branch, seguido de uma descrição curta:
| Prefixo | Motivo |
|---|---|
| feature/ | Implementação de novas funcionalidades |
| bugfix/ | Correção de bugs |
| hotfix/ | Correções emergenciais |
| release/ | Publicação de novas versões |
| refactor/ | Refatoração do código sem mudança funcional |
| test/ | Implementação e mudanças nos testes |
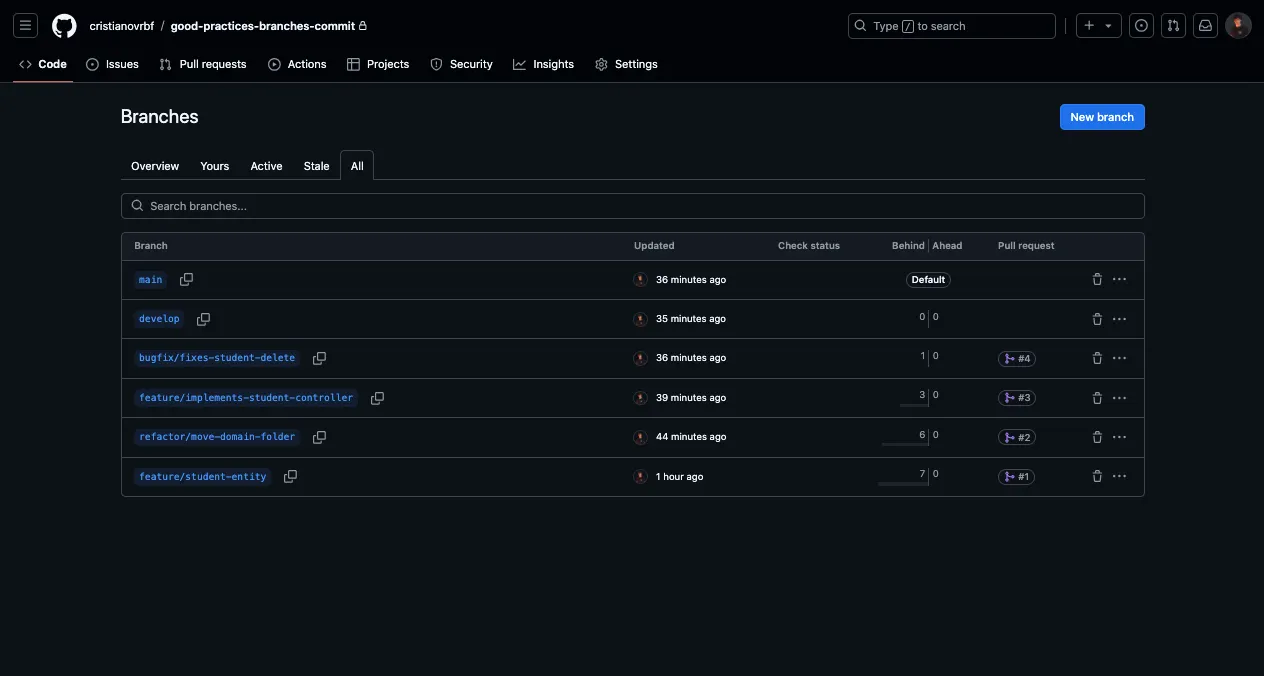
Na imagem abaixo, nota-se a importância da padronização: fica fácil entender por que cada branch foi criada e o que foi desenvolvido nela, além de facilitar a memorização e a comunicação entre desenvolvedores.
Escrita de commits
As mensagens de commit devem ser de fácil e rápido entendimento, transmitindo com clareza quais alterações foram feitas.
Mensagens sem padrão dificultam revisões de código, prejudicam a clareza da linha do tempo do projeto e atrapalham quem procura registros de mudanças específicas. Assim como a falta de padrão nos nomes de branches, a ausência de regras na escrita de commits desvaloriza o versionamento.
Surge então a padronização de mensagens de commit baseada no tipo de alteração realizada, como na tabela abaixo:
| Prefixo | Tipo de alteração |
|---|---|
| feat | Adição de uma nova funcionalidade |
| fix | Correção de um bug |
| docs | Alterações na documentação |
| style | Alterações que não afetam a lógica (espaçamento, formatação etc.) |
| refactor | Mudanças no código que não alteram o comportamento |
| perf | Melhorias de performance |
| test | Adição ou ajuste de testes |
| chore | Tarefas de manutenção, como atualização de dependências |
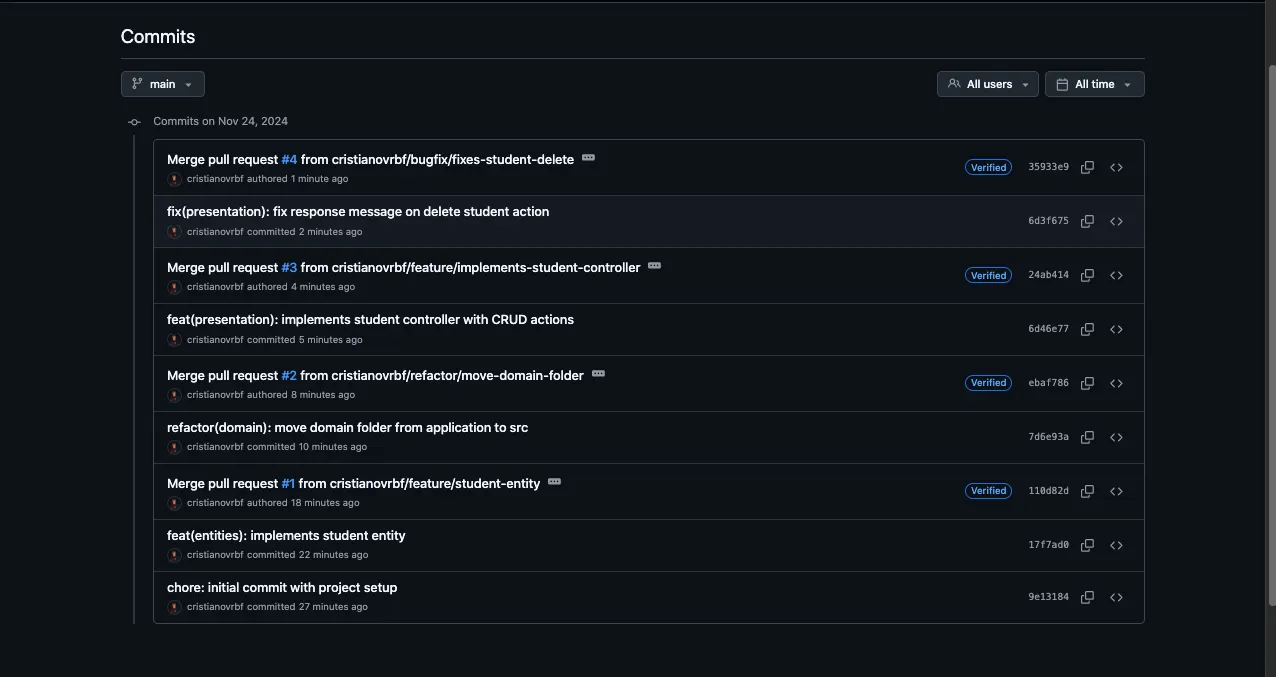
Assim, cada commit pode seguir o padrão:
prefixo(módulo-alterado): descrição rápida sobre a alteraçãoNa imagem abaixo, nota-se a clareza que a padronização traz ao projeto: de forma rápida e fácil, entende-se o que foi feito em cada commit.
Conclusão
Fica claro o valor de implementar essas práticas no seu projeto: melhoram o versionamento de código e a estrutura da linha do tempo, fazem o próprio projeto se tornar sua documentação e facilitam o dia a dia dos desenvolvedores.